De opgave
Een claimdossier bij HDG bestaat uit een bonte verzameling documenten: de intro-mail met de claimnotificatie, de Bill of Lading, de commercial invoice, de paklijst, een printscreen van de containertracking, de data van de temperatuurrecorder, de survey-bevindingen, foto's, prijslijsten en soms een phytosanitair certificaat of een claimbrief van de carrier. Zo'n zestig procent van de informatie komt uit e-mail, veertig procent uit de survey zelf. Geen enkel document draagt hetzelfde dossierkenmerk.
De schade-expert nam al die gegevens veld voor veld over in het vaste Word-template van HDG en vulde aan met standaardteksten en een conclusie. Dat kostte gemiddeld twee tot tweeënhalf uur per rapport. Daarna las een tweede expert het rapport na, en die moest alle bronbestanden opnieuw doorlopen omdat nergens stond waar een waarde vandaan kwam. Bij circa 1.500 rapporten per jaar telt dat op tot ruim 3.000 uur handwerk.
Het volume is bovendien sterk seizoensgebonden. In rustige maanden gaat het om tien tot twaalf rapporten, in piekmaanden om tientallen per week, waardoor de achterstand kon oplopen tot twee- à driehonderd rapporten. En dat terwijl claimnotificaties en rapportages aan strakke termijnen per transportmodaliteit gebonden zijn. HDG wilde dat piekvolume kunnen verwerken zonder het team evenredig te laten meegroeien, zonder in te leveren op de betrouwbaarheid van een rapport dat in claim- en verhaaltrajecten wordt gebruikt.
Onze aanpak
- 01
Eerst het domein, dan de software
We begonnen met het handboek van de surveyafdeling, het rapporttemplate en 23 echte voorbeelddossiers. Daaruit destilleerden we het veldenschema: welke waarde komt uit welk document, wanneer geldt welke standaardtekst en waar de expert altijd zelf aan zet is. Die analyse legden we vast in een functioneel PRD dat samen met HDG in drie rondes is bijgesteld voordat er een regel code stond.
- 02
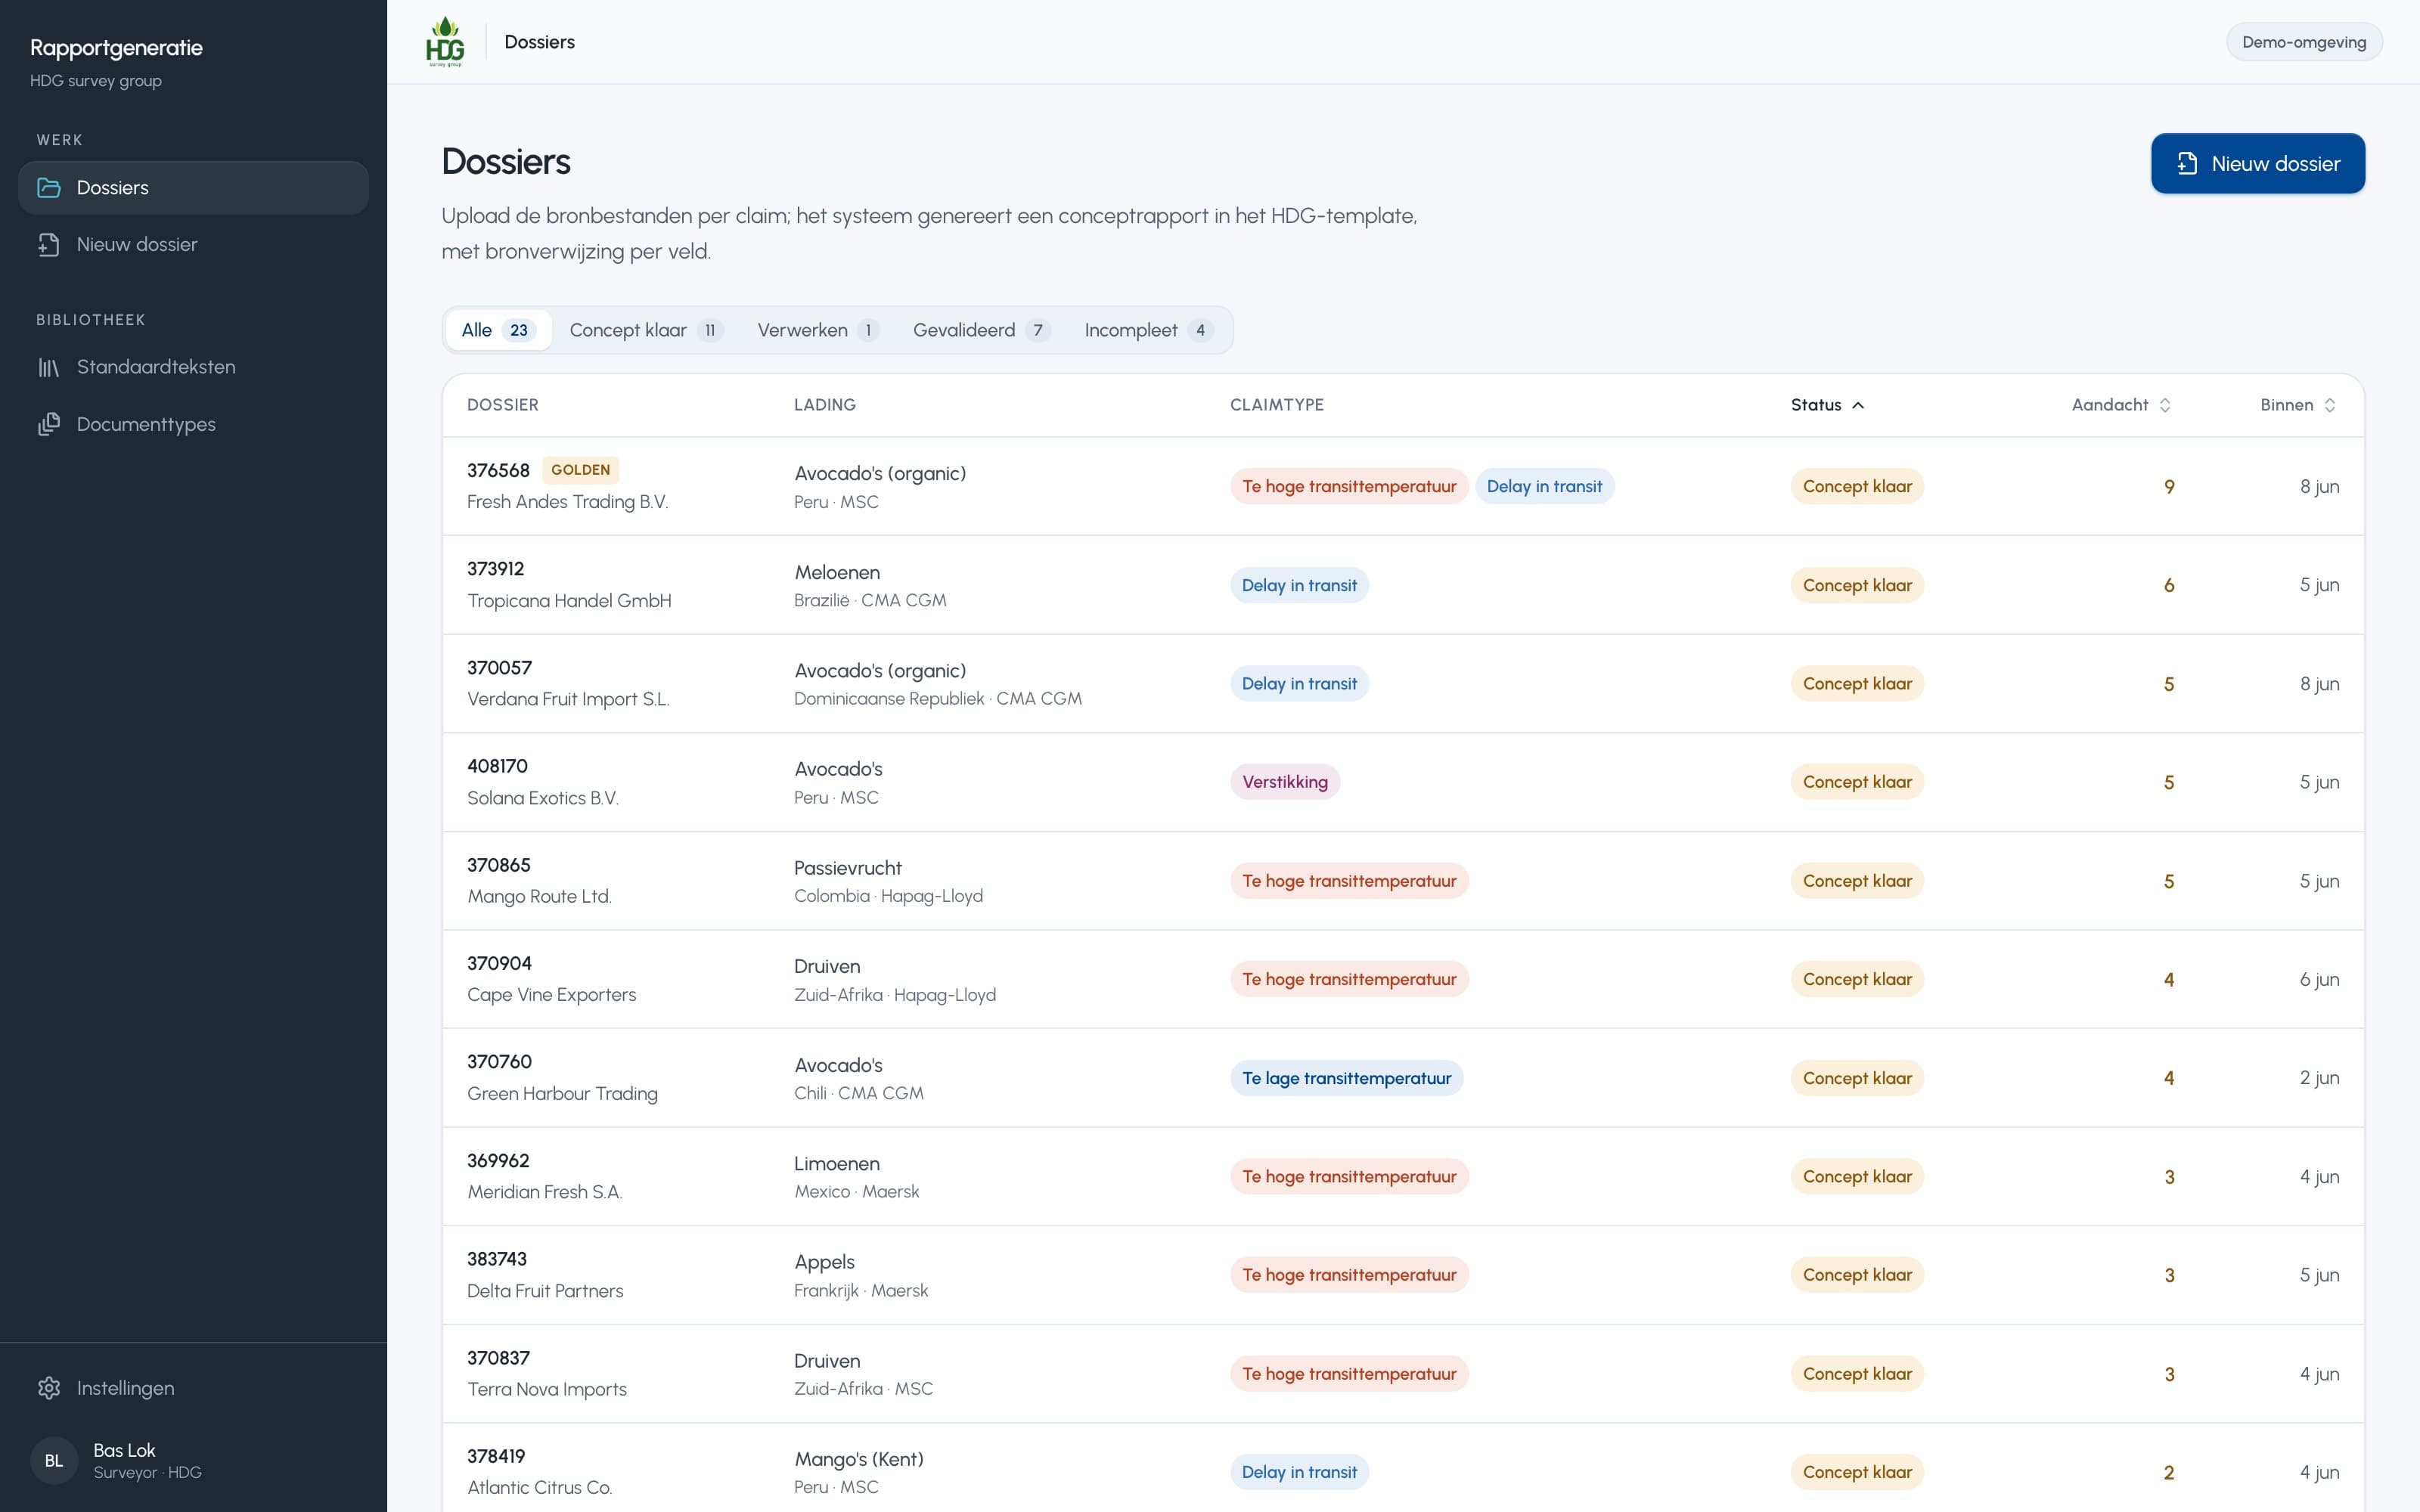
Uploaden, herkennen, uitlezen
De expert maakt een dossier aan en uploadt de bronbestanden. De applicatie herkent per bestand het documenttype, toont welke verwachte documenten nog ontbreken en leest de rapportvelden uit. Alle documenten gaan als beeld naar een multimodaal AI-model, zodat born-digital PDF's, scans, printscreens en handgeschreven formulieren via dezelfde route lopen. Spreadsheets zoals het transit-events-bestand worden deterministisch in code geparsed.
- 03
Elk veld herleidbaar naar de bron
Per veld toont het review-overzicht het document, de pagina en het letterlijke citaat waar de waarde vandaan komt, met een status: gevonden, te controleren of niet gevonden. Die status volgt niet uit een zekerheidsscore van het model, maar mechanisch uit citaatverificatie, validatieregels en het signaleren van tegenstrijdige bronnen. Onzekere of ontbrekende informatie komt zo nooit ongezien in het rapport.
- 04
Een Word-concept in het eigen template
Met één klik genereert de applicatie het conceptrapport in het exacte HDG-template, inclusief de juiste standaardteksten op basis van fruitsoort, claimtype en containerconditie, en een voorzet voor de conclusie. Plekken voor foto's, tabellen en de schadeberekening zijn gemarkeerd; die vult de expert bewust zelf in. Corrigeert de expert een veld, dan genereert het rapport opnieuw met de correctie verwerkt.
- 05
Van kick-off naar hypercare in drie maanden
Kick-off in Ridderkerk begin juni, wekelijkse afstemming per milestone en een expliciet go/no-go-moment per fase. De applicatie draait op Azure Container Apps in de Bonsai-tenant, met inloggen via Microsoft Entra ID en de AI-verwerking in een EU-regio. Sinds de livegang in augustus testen de schade-experts met echte dossiers en verwerken we hun feedback in korte releases.
Het resultaat
De doelstelling die met HDG is afgesproken: de opsteltijd per rapport van gemiddeld 2,25 uur naar circa 0,75 uur, een reductie van twee derde. Bij 1.500 rapporten per jaar komt dat neer op ruim 2.000 uur die terugvloeit naar het inspectiewerk zelf. Even belangrijk is het effect op de tweede lezer: die valideert een rapport via de bronverwijzingen in plaats van alle documenten opnieuw te doorlopen.
De applicatie is live en zit in de hypercare-fase. De cijfers uit de praktijk delen we zodra de eerste piekperiode is verwerkt. De rapportgeneratie is daarnaast een vast onderdeel van het nieuwe keurplatform dat we samen met HDG bouwen als opvolger van QC4U.